Кто говорит — до сборки. Голос — из целого исходника петлички 32-bit float, уровень — по речи, варианты — на слух до рендера, музыка — настроение блока, тишина — приём. Мастер −14 LUFS.
«Петли у нас пишутся на 32 bit float, и очень важно править именно исходник»Роман, 03.10.2026
Source → Speakers → Level → Clean → Compare → Assemble → Music & SFX → Master. Кто говорит и выбор голоса решаются до сборки — дальше ничего не угадываем.
🎙
01
Source
целый TX##_MIC###_orig.wav · float 32 · 48 кГц; петличка под каждый клип
⇒ 01_Source_Sound✓ not _edit, not _timeline, not camera
machineRoman decidesST1 approach code · opens the card
Approaches
Голос, кто говорит, края реплик, сравнение, тишина, музыка и уровни — подходы с примерами из фильмов.
речь — из петличек 32-bit float, а не со звука камеры: YTCH14 — 11 файлов
голоса разных людей и сцен — к одной громкости (v4, просьба Романа)
кто говорит — по петличке, а не по ТЗ: фраза «её голосом» для тизера оказалась куратора из комнаты
перед работой — ffprobe sample_fmt: съёмка YTFP S1 — 24 бит; сведённые TX*_timeline.wav бывают короче сцены — брать из _orig
YTUVI01 build_v5.py audio · 999_extra/bin/voice_isolate · YTUVI01 src_master.py enh (editor Adobe Enhance tracks found by waveform; check windows 8+ dB louder) · 05_editing/0514_teaser/master.py (voice.lav, voice.lav_t0, voice_level) · _tools/loud_pieces.py · 05_editing/0511_doc_cut/voices.py measure|plan · ffprobe codec_name = pcm_f32le
YTCH14 · Звук: чиним исходник · шортсы YTUVI01 v5 16.10: голос с петличек исходников цепочкой фильма + изолятор, а не звук готового фильма; речь над шумом: студия 50 дБ (было 36), SSEF 33, машина 29 · тизеры и трейлер YTAgeFree S3 06.10: каждый кусок к −20 LUFS, мастер −14 («звук выравнял») · YTUAE02 15.10: Анжела у камеры громче на 8–11 дБ — выровнено · YTFP02 04.10: исходник 24 бит, не float
время слов общей расшифровки врёт на 1–7 с: кусок расшифровывается заново, край — по огибающей речи
звук режется точнее кадра
сверка Whisper-ом готовой сборки: 67 из 79 реплик слово в слово, 12 разобраны
текст у края выравнивают по звуку микрофона куска (CTC MMS_FA): рез — в тишине до слова и в первой настоящей паузе после
хвост — двумя порогами: пол + 10 дБ находит слово, пол + 5 дБ — где хвост ушёл в тишину («license» без «s»)
повторное распознавание дописывает срезанное слово — мерило края выравнивание и огибающая, а не Whisper
05_editing/0513_lesson_cut/lc.py (qc_seams, qc_src): pauses > 0.9 s outside screen windows, lone short sounds at seams, repeated phrase within 2 min · 05_editing/0511_story_cut/sc_align.py edges|show|audit (MMS_FA) · 05_editing/0511_doc_cut/align.py export|memex|merge, story.py resolve · 05_editing/0510_headless_cut/solo.py verify|letters|edges · 05_editing/0514_teaser/verify.py, edges_pick.py · 999_extra/forced_align/forced_align_words.py (environment/.venv_whisperx)
YTCH14 · Правила: звук и рез · уроки YTUVIE01 с 13.10: скан швов собранной речи · YTCR04 02.10: 0 резов вне паузы из 458 краёв (до того ~45 кусков из 229 теряли слово) · YTCG39 05.10: 41 плохой край из 122 · YTEVO03 27.09: ~40 % краёв плохие → 183 по звуку · YTEVO02 v6: обрывы на 11:29 и 15:07 · YTAgeFree16 12.10: verify поймал чужой отрывок
YTCH14 v3: 7 мест тишины на 16 кусков · YTCR04 v7.1 03.10: письмо и «90 %» в тишине удлинённой паузы · YTFP02 04.10: крючок «Он глухой» · YTEVO03 v7–v10: пик фразы и вдох после него — в тишине
кусок музыки — глава или её поворот; энергия 0–4 по главам
трек — по смыслу и замерам: тревога — под рассказ о побеге, гитара — под главу, где она «раньше детям играла»
подъём — на «больших» словах: «сотни людей по чуть-чуть поверили в тебя»
под речью — не громче −20 дБ к речи
блок описывают словами по его тексту (теги mood с весами), а не по жанру канала; по 3 трека на главу, трек — один раз на фильм
13 похожих треков делают главы одинаковыми — разные треки под смысл
Epidemic MCP SearchRecordings, EditRecording · 05_editing/0511_story_cut/sc_music.py plan · 999_extra/story_map/story_music_fit.py --project P · 05_editing/0510_autocut/audio_music.py
YTCH14 v3 · все 16 кусков — вкладка «Кейс» · Музыка и звуки · YTCR04 v7.2: 7 треков по главам, 21 блок с треком, входом и энергией · YTUVI02 v7 22.10: свой трек на каждую главу ровно под её длину · YTCH10 05.10: 13 фрагментов · YTEVO03 · YTEVO02 02.10: «Музыка нужна»
Звуки, которые показываем · YTCR04 v6–v8: удар на заставке каждой главы, свист на входе в карту · YTLAB01: stinger на плашках глав · уроки YTUVIE с 05.10 (1.1.1 — 110 событий) · RSC004 06.10: 147 событий по кадрам · YTUVI02 v6–v7 · YTAgeFree16 v4: 4 новых звука · YTTRBM03 v6 25.10: штамп на ответе блица
03.10 · Roman · stage canon · YTEVO03: пики +10…+31,9 dBFS · YTEVO03 18.09: медиана речи −20,2 дБ по 105 дублям · YTUVIE 23.09: потолок усиления 20 → 34 дБ для тихого второго · YTAgeFree12–14: громкость врезки — по речи героев этого мастера, а не по −14 LUFS
03.10 · 17_audio/standard.py · одно место чисел для всех движков · YTEVO02 v7 02–03.10: выдача не прошла синхрон — ракурс B на −35 мс → _qcfail_sync, лишнее кодирование всего фильма
03.10 · 19.10 · YTLAB01 · YTEVO04 · слова с ролями — вход Cut, плашек, субтитров и шортсов · YTCR04: −7…−9 дБ на петличке героя — он сам, −21…−27 дБ — человек поодаль · YTCG37, YTCR04: ранний этап — имена SPEAKER_XX по содержанию реплик · YTTRBM01 02.10: роли субтитров RU/EN — pyannote + агенты по тону, роду глаголов и кадрам; «Гость» вместо «Семён» — шортсы без плашек: имена ролей = ключи hosts и people · YTLAB01 v5 03.10: 146 путаниц → 0, исправлено 99 титров из 1 064 · YTUVIE день 1 24.09: 361 сегмент по уровню петличек · YTEVO04 19.10: о. Аркадий и Ростислав · YTEVO03: склеенный голос на TX03 (144 реплики) переразмечен · YTCG48 05.10
12.07 · 26.10 · Roman · рецепт C выбран A/B 12.07 · YTUVI01 v7 «звук офиса» · музыка: YTCH12 06.10 — страница замены музыки («мне всё понравилось») · YTEVO03 04–11.10: по 3 трека на главу на странице структуры · YTFP02 04.10: трек куском фильма на уровне мастера · YTCG37 v1 02.10: эхо — варианты на одном куске
Music under speech ducked by the sheet, lifted in pauses
под речью музыка на 20–22 дБ тише речи и не ближе 18 дБ; в паузах от 1 с поднимается, под главной фразой — тишина
бит с голосом — трек приседает, бит без голоса (воздух, заставка, карта) — подъём; паузы внутри реплики музыку не качают
уход музыки заканчивается до первого слова (story_cut — за 0,35 с), вход мягкий 0,3–2,5 с
вторую систему громкости (ffmpeg-normalize, sidechaincompress) не вводить: наш даккинг знает о речи заранее
17_audio/standard.py · 05_editing/0514_teaser/master.py (music.duck_by: beats, music_dips) · 05_editing/0511_story_cut/sc_sound.py music · 05_editing/0511_doc_cut/sound.py music · 05_editing/0510_headless_cut/music.py
03.10 · stage canon · YTCH14 v3: медиана −26,5 дБ к речи · YTAgeFree16 v3 18.10: по битам листа · YTUVI02 v6–v7: ~17 LU под голосом, подъёмы в паузах до +8 дБ
музыка уступает речи только в полосах и моментах, где глушит её: 18 полос 1/3 октавы 160 Гц – 8 кГц с весом важности SII 05_editing/0510_headless_cut/carve.py (job key music.carve; without the key the film sounds as before)
Music bed kept even: quiet intros and breaks lifted
YTCG37 v2 03.10: музыка пропадала на полминуты — исправлено level_bed · autocut держит пол подложки −26…−28 дБ к речи
тихие вступления и брейки трека подтягивают к обычному уровню: не ниже «обычный − 3 дБ», подъём ≤ 10 дБ, сглаживание 3,5 с 05_editing/0510_headless_cut/solo.py (level_bed)
Picture rendered without music, music muxed afterwards
RSC004 v2 03.10: рендер только со звуками, три пересборки музыки наложены mux.py
ролик рендерится без музыки, музыка накладывается отдельным шагом — варианты трека и тишину сравнивают без пересчёта кадров RSC004 mux.py (render without music, then ffmpeg mux)
Voice rebuilt from lav sources over the editor's cut
YTUVI02 v7 21–22.10: голос Натальи из петличек по монтажу Сони, голос над музыкой 13 дБ
музыка вшита под речь в миксе монтажёра — голос собирают заново из петличек по его монтажу и кладут свою музыку YTUVI02 05_Review/work/v2/claude_edit/tools/v7_voice.py (map -> refine -> retake -> split -> fix -> find/set -> build)
Finished sound retimed to a re-animated cut by a time-warp
RSC004 21.10 v5: сцены длиннее на +10,5 с (YouTube) и +7 с (конференция) — новый звук за ~2 ч
аниматор перерисовал сцены — звук не собирают с нуля: функция времени «старый → новый» по событиям кадра (клики, штампы, склейки) RSC004 sound_2026-10-21/ (align.py, anchors.py, events.py, warp.py, trap_v7.py, vo_v7.py)
Splice by pitch: same intonation, PSOLA glide, spectral seam audit
«Добрые дела» 22.10: стык «что лучик» — шесть заходов после «всё равно слышу склейку»; слышимая склейка давала 390–520
слово для стыка берут из места с той же интонацией, сверяя F0 с шагом 20 мс; где такого нет — высоту ведут кривой Praat PSOLA ~/YTAI/YTs/YTUVI/dobro/psola_glide.py (praat-parselmouth) · voice_cut.py (glide, pjoin)
Whisper timing artifacts fixed in the tape: retakes, stretched words
YTUVI03 v2 → v3 15.10: 15 мест
ведущий перечитал фразу, а в расшифровке одна строка (текст одного дубля, время другого): признак — слово > ~1,5 с или пауза 3–7 с YTUVI03 00_Setup/08_Cut/_tools/takes_align.py + 05_editing/0511_story_cut/sc_align.py · sc_build.py · 999_extra/story_map/story_to_storycut.py
Leaked word fragment at a seam muted in place, time unchanged
YTEVO02 рилс S05 и фильм 8:04 11–12.10: «…действия [саду]. Поэтому» · YTEVO02 v4 (autocut mutes)
на стыке, где в съёмке вырезана фраза, у каждого шва распознают окно ≥ 1,3 с с обеих сторон по собранной речи 05_editing/0510_autocut/autocut.py (directives -> mutes) · ffmpeg aeval
YTUVIE01 23.09: дыры 295,7–324,7 и 459,6–488,7 с · YTUVIE 2.1.2 v4 16.10: добор asr_gapfix
Whisper large-v3 на петличке теряет целые окна по 15–30 с посреди речи: дыры > 8 с сверяют со словами камеры (turbo) и заполняют 13_preprod/1304_visual_tz/lesson_spine.py (fill_holes) · asr_gapfix.py (lesson round tools)
Voice slate: lesson and take number spoken into a TX
YTUVIE, студийные уроки
в студии продюсер голосом называет номер урока и дубля на TX02 перед дублем — номер дубля живёт в звуке TX02 as a voice slate · 01_prepare/0121_studio_day/ (day.json)
разбор каждой петлички там, где говорит её человек: уровень речи и пол, клиппинг, баланс полос (гул, бубнение, свист шипящих) 05_editing/0510_headless_cut/sound_qc.py --job J [--master <cut.mp4>]
Singing and services: live sound from the nearest mic, no denoiser
YTEVO03 v10 14.10: молитвы на освящении −11,6 / −11,5 LUFS с FX3-1258
молитва, пение, служба — живым звуком с ближнего микрофона (канал камеры рядом), а не шумодавом; музыка под ними тише на 9 дБ 05_editing/0511_story_cut/sc_sound.py
live
Код подхода постоянный — по нему подход называют в плане фильма и хэндоффе. new — решения Романа и Тани 02–26.10 из хэндоффов и памяти: раньше их не было ни на одной странице. Пунктир — open: в фильм только после решения Романа. Как добавить новый подход — Edit · Add.
Speakers
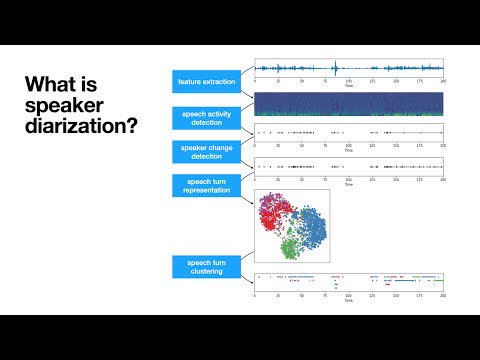
Распознавание участников: по петличкам, физике звука, отпечатку голоса и лицам. Делается один раз на ингесте — им пользуются Cut, плашки, субтитры и шортсы.
🎙
Lav map
cast.json → mics
кто на каком передатчике: задание съёмки, проверка фразой известного говорящего
live
📊
Word by lav level
YTLAB01: 146 → 0 errors
у каждого своя петличка: разница уровней в окне слова; уверенно за ±6 дБ, между — наложение речи
live
🧲
Physics relabel
YTEVO03 · YTEVO04
петлички без закрепления: полоса DJI-N собрана из разных TX, Pocket a1 − a0, решать по куску речи
live
🧬
Voice print
Roman · Pavel YTLAB01
pyannote wespeaker — только где петлички не решили; реестр голосов канала — затравка, не ответ
live
🙂
Faces
shorts YTFP01 · YTUAE01
YuNet + SFace по эталонам: кто в кадре (плашка только на своём); SyncNet — кто говорит в кадре (рамка шортса)
live
📖
Read check
YTEVO03: a line given to the wrong person
читать ленту по смыслу: кто кому отвечает — последняя проверка до сборки
live
⇒
Выход — слова с ролями ({base}.words.json, имена = ключи hosts и people): по ним режет Cut, ставятся плашки и субтитры, выбираются шортсы. Сделано до сборки — дальше никто не угадывает, кто говорит.
Порядок — сверху вниз: следующий способ включается, только где не решил предыдущий. Подход SO12, проверка петлички SO14.
Compare
Варианты на одном куске и одной громкости; выбор Романа становится умолчанием канала — следующие фильмы проще.
Voice ladder
Orig · Soft 60 % · Clean · Warm (рецепт C) — один кусок, −16 LUFS, подряд на странице версии
три трека на блок с плеером на странице версии; без ответа — объявленное умолчание
Выбор Романа записывается в YTs/{CH}/sound_profile.json (с 26.10, заведены 12 каналов, все ждут A/B): speech.by_engine — вариант лестницы, доля голоса, EQ; следующий фильм канала берёт его без нового A/B, задание фильма главнее. Читают 0510 solo.py dialog и 0511 sc_sound.py; проверка — python3 ~/YTAI/scripts/17_audio/sound_profile.py check. Музыка — в журнал музыки.
Сравнивают до рендера: выбор один раз на канал или на микрофон упрощает все следующие фильмы. Подход SO13. Проба 26.10 — Proof · Voice EQ A/B ↗: ждёт вашего выбора.
Choose
Сначала — правильный исходник, потом симптом → подход.
Source
voice only from the speaker’s own lav
Source
What it is
Use
DJI TX lav · whole _orig.wav
float 32 · 48 kHz · mono · ~30 min
voice source, always
live
Recorder with lavs (headless)
WAV in 01_Source/Audio/
source; film time follows it
live
_edit.wav
processed by the recorder, some takes shorter
not a source
skip
*_timeline.wav
compressed Premiere sequence time
not a source: cut accuracy ≤ 0.67 s
skip
Camera audio
24-bit via the MI adapter: more room
sync only
skip
DJI camera AAC
recorded clipping; -ac 1 merges two people
not a source
skip
If something is off
symptom → approach
Echoey voice: the lav records the room
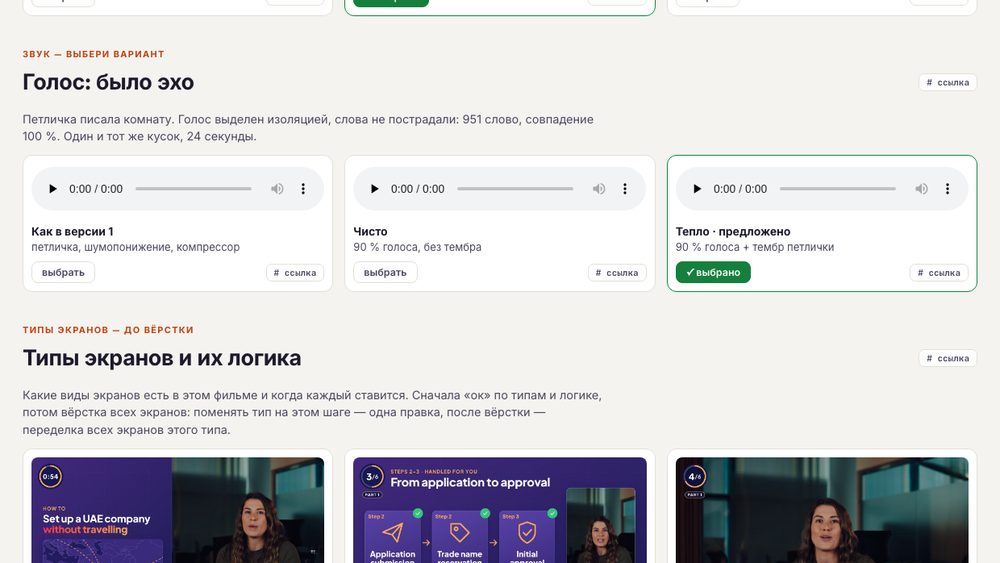
изолятор 90 % + 10 % живой петлички; чистить до компрессора
роли по уровням петличек, а не по диаризации; петлички без закрепления — по физике звука
заменить речь в миксе, не пересобирая: g(t) по блокам, чистая речь DeepFilterNet
Наш рецепт против совета из рилса, который прислал Роман. Решает ухо — на одной громкости.
our recipe C, warm with body: +4 dB 120 Hz · +1.5 240 · +1.5 3.5 kHz · −1.5 9.5 kHzreel advice: low cut ~80–100 Hz, remove mud 200–500, the top appears by itself
W@whereismydelay24.10.2026
Roman: «Вот это для голоса»
Voice EQ: what did not fit in the reel
100 Гц — ориентир, не закон: у низкого голоса основной тон уходит к 80–90 Гц — вести фильтр вверх, пока голос не «худеет», и чуть вернуть. Глухо — не крутить верх: в девяти случаях из десяти это каша 200–500 Гц. Сравнивать с выключенным EQ на той же громкости — громче всегда «лучше».
Take: проба на одном куске: рецепт C против «срез низа + минус каша» — обе версии на одной громкости (−16 LUFS) в лестнице голоса; выбирает Роман на слух (SO9). Рецепт C поднимает 120 и 240 Гц — ровно там, где совет режет: спор решает ухо.
Музыка — настроение и динамика блока, не фон; звуки — показ события на экране.
Describe the block in words
настроение — из слов речи и места блока: хук — эмоция, глава — вопрос, финал — выход; в коде — теги mood с весами (hopeful +2, dark −3)
динамика — темп речи и роль блока: энергия 1–4, как в палитре монтажёра (1 едва слышно … 4 почти в голос: −26 / −20 / −11 / −2 дБ к файлу)
где пик и где пауза: заставка, карта, финальная карточка — там музыка поднимается; под словами — ровная
блок описывает сессия по его тексту, не по жанру канала
YTCR04: 21 блок с треком, местом входа и энергией — 08_Cut/music_palette.json
What we search in Epidemic
term словами («hopeful piano strings slow build») + фильтры: moodSlugs, taxonomySlugs (жанр), featuredInstrumentSlugs, bpm, duration, vocals=false
SearchSimilarToRecording — похожее на понравившийся трек; SearchExternalReferences — референс из Spotify
превью меряются: громкость, LRA, нарастание, где пик, атаки в минуту, доля 2–4 кГц, доля голоса
стемы FULL · INSTRUMENTS · BASS · DRUMS; под речью звучит INSTRUMENTS — без ударных, баса и мелодии
autocut: 10 запросов → 37 тем и 43 подложки в scout.json
What we don't take
вокал под речью: vocals=false в поиске, −10 за вокал в тегах, −4, если изолятор слышит голос (доля > −8 дБ)
трек громче речи и «дышащий» на паузах: вне заставок пауза даёт не больше 30 % подъёма
много резких ударов (> 60 атак/мин), неровная подложка (LRA > 10), тема вне 140–300 с, жанр «медитация»
название, которое спорит с посылом фильма (см. грабли)
YTEVO · music/choice.json, поле why
Music changes with the structure
тема — открытие, карточки глав, финал; подложка — блоки других дней; под разговором музыки нет (autocut, headless)
трек на блок по палитре монтажёра: 45 кусков и 23 отбивки на 27 минут (story_cut)
внутри блока: тихий вход, «тело» записи и дроп — на заставку, уход под первые слова; нарастание — на название; финальный удар — на финальную карточку
один трек на всю программу — только короткий ролик канала (solo, 4:42); подложка одним уровнем на весь фильм — фон, которого канон не хочет
SFX we show
an on-screen event gets a hit, whoosh or click
Event
Where in the film
In code today
Needed
Chapter card
карточка или плашка главы
story_cut: Ping Boom −12 дБ из палитры монтажёра; headless: stinger Epidemic −2 дБ RMS к речи с главы 2
solo, doc_cut, autocut — построить
Entering the map
map_route, map_place, map_world
story_cut: свист whoosh −20 дБ, удар за 0,48 с до кадра
остальные — построить
A number lands
экраны number, counter; выноска viz считает 0,8 с
нет
клик или тик на остановке счётчика — 💬 моё мнение
A plate appears
lower third, имя, плашка шортсов
нет
короткий мягкий свист на кадр появления
The map draws
линия маршрута, точки
нет (только вход)
шелест на длину рисования, тише отбивки
Piece change in a short
стык двух реплик
нет; клиент music.py умеет sfx(), команды нет
команда shorts.py sfx — открыто
Откуда: SearchSoundEffects (term, ≤ 3 с) → DownloadSoundEffect WAV (02.10 пришёл 96 кГц); похожее — SearchSimilarToSoundEffect. Уровни как у отбивок: удар −2…−12 дБ к речи, клик тише; звук — на кадр события, не в слово. Список событий утверждает Роман.
Numbers
Одно место чисел — 17_audio/standard.py; уровни музыки — из движков и проверок.
Master loudness
−14LUFS ± 1
−24−8
паспорт YouTube −14 ± 2; пик ≤ −1 dBTP; LRA ≤ 8
Music under speech
−21dB to speech
−32−14
не ближе −18; без речи подъём до −9, не выше −6
Isolator input
−30speech LUFS
−50−10
громкую речь модель роняет; потолок −1; сдвиг ≤ 48 сэмплов (1 мс)
«источник − голос» под речью; перебивки story_cut −30, укрытия −38
Tape ingest (Premiere track)
−23LUFS ± 1
−30−14
EBU R128; 9 LU запаса до мастера
Полоса — допуск, чёрная метка — цель, цветная — эталон или граница, о которой говорится в подписи.
Toolbox
Изолятор, стемы, синхрон, роли, музыка и голос.
voice_isolate
live
системный AUSoundIsolation офлайн, ×80 реального времени, float32 той же длины
~/YTAI/scripts/999_extra/bin/voice_isolate --wet 100 --quality high
audio.py stems · clean · assemble
live
стемы f32, четыре варианта голоса, сборка речи по сэмплам
$V $AC/audio.py stems
sync.py measure
live
сдвиг петлички к камере по огибающей, MAD ≤ 12 мс
$V $DC/sync.py measure
17_audio/standard.py
live
одно место чисел мастера для всех движков
~/YTAI/scripts/17_audio/standard.py
Epidemic Sound MCP
live
музыка и SFX: поиск словами, похожие, правка под длину; канал — в safelist
SearchRecordings · EditRecording
ElevenLabs v4
live
голос с ударениями — суфлёр YTUVI
MCP / API
pyannote · mlx-whisper
live
кто говорит и слова со временем
wordrole_transcribe.py
fillers_v9
trial
паразиты: «вот», «ну», «как бы»; «э-э» — не ищет
YTEVO03 _session_tools
Adobe enhance speech
trial
второй вариант чистки речи
Adobe MCP
Next
Решения с GitHub и из сети под звук: паразиты, доли, саунд-дизайн, чистка речи.
Кандидат попадает в фильм только через пробу на кадре настоящего фильма и «ок» Романа — тогда он становится подходом с кодом. Звёзды, лицензия весов и Mac проверены у каждой строки (исследование 14.10).
Take now
first to try · 5 of 25
Filler and hesitation stage for RussianMLX Whisper + MMS_FA + Silero VAD + F0 + Claude по тексту
Take now#26K04effort M
Filler and hesitation stage for Russian
Четыре слоя: лексика (вот/ну/как бы/типа/это самое/короче), хезитации «э-э/м-м» акустикой, второй ASR для полноты, Claude решает «паразит или смысл».
Where: Вынести fillers_v9.py в общий этап (05_editing/0517_fillers) для story_cut, doc_cut и shorts.py.
Событие (экран, цифра, свайп, склейка, метка GSAP) → класс звука → звук встаёт своим пиком или атакой на событие, а не началом файла; по желанию — на долю.
Where: Вынести sfx_events/cmd_sfx из 0513_lesson_cut/lc.py в 17_audio; события — screens JSON, лист монтажа, метки композиций HyperFrames.
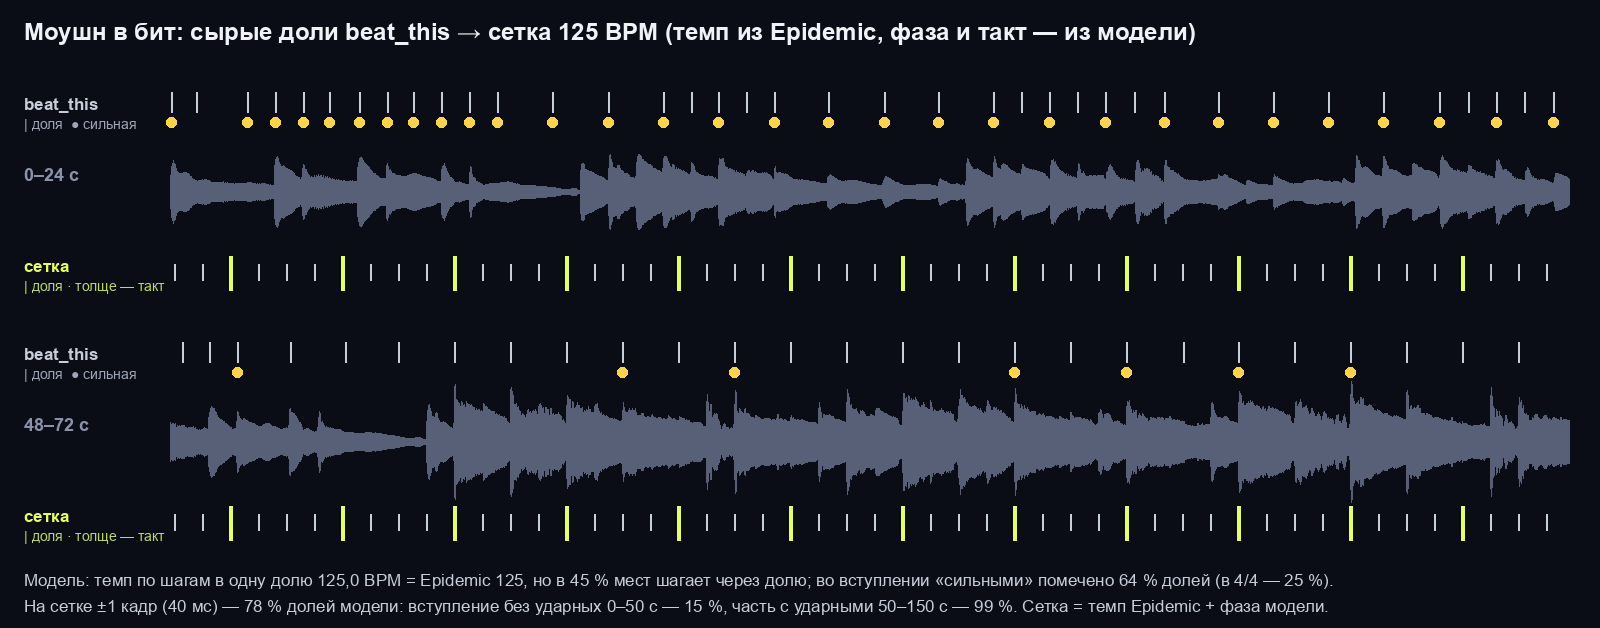
Трек Epidemic «For Everyone» из YTEVO03, 3,5 мин, CPU. Темп модели по шагам в одну долю — 125,0 = Epidemic 125, но в 45 % мест она шагает через долю. Во вступлении без ударных (0–50 с) на сетке ±1 кадр только 15 % долей, в части с ударными — 99 %. Акценты ставим на сетку: темп Epidemic + фаза и такт модели. № 27 beat_this
Вместо общего −16 дБ под речью — провалы только в полосах, где звучит голос (цепочка peaking по анализу речи), плюс выравнивание уровня. Приём уже есть в нашем стеке и проверен в HyperFrames; дешёвый способ поднять музыку в фильмах.
Русский ASR: средний WER 8,4 % (v3_rnnt) против 25,1 % у Whisper на пяти доменах; e2e-версии с пунктуацией; таймкоды слов с 04.2026. Лучшая открытая русская модель под MIT и локально: дешёвая страховка полноты для T1 и точности субтитров для T3.
STT с таймкодами слов, русским, диаризацией и keyterms; по умолчанию пишет паразиты и фальстарты, а no_verbatim=true их убирает. Самый быстрый путь к verbatim-русскому при оплаченном аккаунте; проверить на 10 минутах YTEVO03 против ручной разметки.
Whisper подражает стилю подсказки: если в ней «Ну, э-э, вот… как бы, м-м», он чаще оставляет паразиты (OpenAI: сохранение filler words). Эксперимент на полчаса; если сработает на русском — локальная замена облачному Scribe для чувствительных фильмов.
Ставит таймкоды словам по готовому тексту для 11 языков, включая русский, кусками до 5 минут. Уже на диске и на MLX, закрывает известные промахи MMS; без замены основного выравнивателя.
CLI и библиотека для 100+ моделей UVR: голос/музыка (BS-RoFormer SDR 12,9), dereverb, de-echo, denoise, crowd. Единственный путь на Mac к SOTA-разделению и dereverb одной командой; Demucs внутри есть — отдельно не ставить (жив форк adefossez).
Линейное предсказание с задержкой: вычитает поздний хвост комнаты и ничего не выдумывает; работает и на одном канале. Дёшево, детерминированно и хорошо складывается с нашей изоляцией; если tail_db не вырастет заметно — выбросить.
Звук по тексту длиной 0,5–30 с, бесшовная петля (loop), prompt_influence, выход pcm_48000. Дёшево и уже оплачено; дополняет Epidemic там, где нужен конкретный звук бренда или предмета.
Музыка 10 с – 10 мин по описанию с контролем BPM, тональности и размера; правка кусков, стемы, LoRA на своих треках; коммерция разрешена. Единственная открытая музыкальная модель с коммерческой лицензией и MLX; пробовать точечно в промо, не в фильмах.
Одной моделью: темп, доли, сильные доли, границы и метки частей трека (intro/verse/chorus/bridge/outro), обучено на Harmonix. Полезно, но не сейчас: на Mac ставится с боем, а кульминацию мы уже ставим через Epidemic. Вернуться после влития PR #39.
Выделяет звук по описанию («speech», «church bells», «crowd»), по маске объекта в кадре или по отрезку времени; модели small/base/large. Новая возможность, но голос и музыку уже закрывают RoFormer и AUSoundIsolation. Брать, когда понадобится «убрать конкретный звук».
Чистит признаки w2v-BERT и синтезирует речь вокодером заново; по авторам сравним с Google Miipher, многоязычный, очень быстрый на GPU. Сильный кандидат на случай «звук безнадёжен», но не для основных дорожек: честность голоса героя важнее.
Verbatim-Whisper: пишет [um]/[uh], повторы, обрывы; v2.0 многоязычный, границы слов 29,6 мс (TIMIT). Лицензия закрывает путь, а Scribe v2 на английских паразитах не хуже (95,5 против 94,3) и уже оплачен.
Классический MIR-пакет: доли RNN+DBN, онсеты, аккорды — эталон до 2024 года. beat_this точнее без DBN и под MIT; остальные дают либо лицензионный риск, либо хуже доли. Держать один трекер.
Skipeffort S
#45
Parakeet v3, WhisperKit, lightning-whisper, Apple SpeechTranscriber ↗
Быстрые альтернативы нашему MLX Whisper: Parakeet-TDT 0.6B v3 (25 языков, русский есть), WhisperKit (Whisper на CoreML), SpeechTranscriber macOS 26. Ни одна не точнее Whisper на русском; второй русский ASR — это GigaAM v3, а не ещё один быстрый Whisper.
Шумодав MossFormer2_SE_48K, AV-выделение диктора по губам (16 кГц); Resemble — генеративный «студийный» энхансер; VoiceFixer — 2021 год. Дублируют то, что уже есть и выбрано на слух; держать в уме только AV-выделение диктора.
Готовая нормализация по EBU R128 и даккинг музыки компрессором с внешним ключом (голос). Свои инструменты точнее и откалиброваны с Романом; добавлять вторую систему громкости вредно.
Генерация шумов (фоли) синхронно с картинкой — шаги, ветер, посуда — по видео и тексту, клипы около 8 с. Лицензии и железо закрывают путь; синтетический шум в архивном кадре документалки ещё и этически спорен.
Локальная озвучка и клон голоса по образцу; Chatterbox V3 (MIT) знает русский среди 23 языков. Коммерчески чист только Chatterbox, но по русскому он уступает ElevenLabs, который оплачен и настроен на голос Романа.
Речь → речь: начитать досъёмку своим голосом с нужной интонацией и перекрасить в тембр героя. ElevenLabs делает то же лучше и уже оплачен; главное ограничение здесь этическое, а не техническое.
Skipeffort M
References
Сохранённые Романом посты о голосе, музыке и звуке.
W@whereismydelay24.10
Roman: «Вот это для голоса»
Voice EQ: what did not fit in the reel
Срез низа ~100 Гц — ориентир: у низкого голоса основной тон 80–90 Гц, фильтр ведут вверх, пока голос не «худеет». Глухо — убрать кашу 200–500 Гц, а не крутить верх. Сравнивать с выключенным EQ на той же громкости.
Take: проба в лестнице голоса: рецепт C против «срез низа + минус каша», обе на −16 LUFS — выбирает Роман на слух (раздел «Эквалайзер голоса»).
Чужие ролики на сайт не кладём — только описание, вывод и ссылку на пост. Файлы, расшифровки и листы кадров — на SSD: /Volumes/T9-Black-2-RYA/_refs/2026-10-25_roman_saved/. * Instagram (Reels) принадлежит компании Meta Platforms Inc., признанной экстремистской организацией; её деятельность в России запрещена.
Channels
Звуковая цепочка движка каждого канала; мастер у всех один.